Инструменты анализа датасетов и ML-инфраструктура
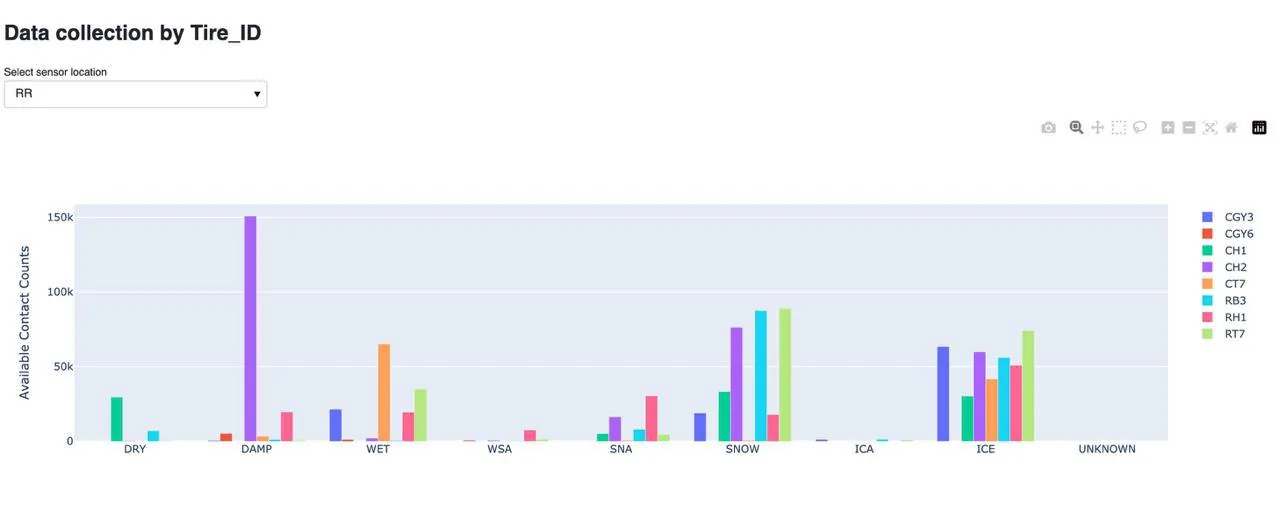
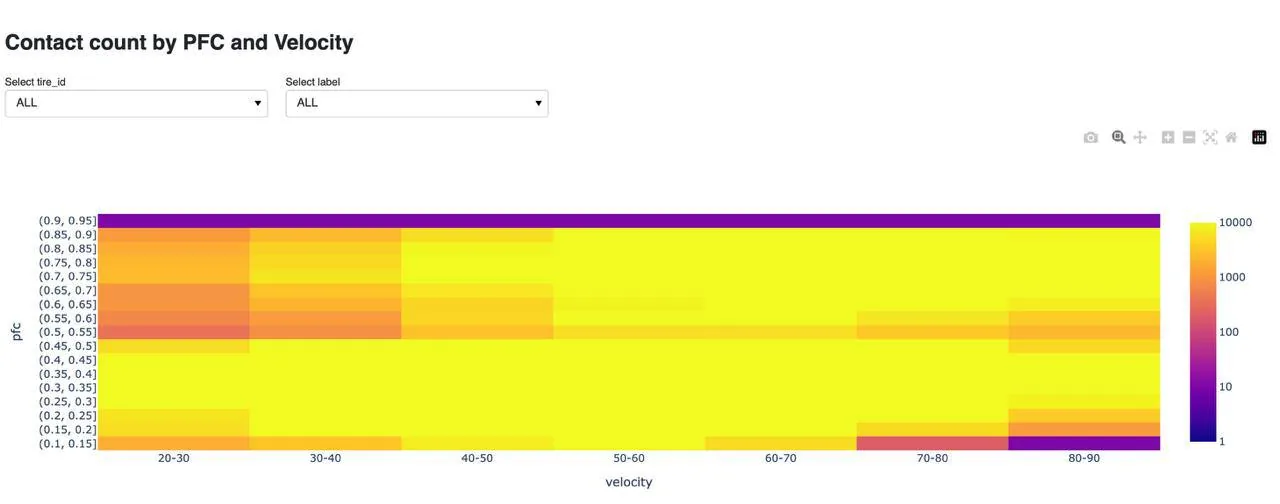
Мы реализовали автоматический анализ данных через HTML-дашборд, который позволяет быстро оценить качество, полноту и распределение данных без ручной проверки, и систему экспериментов для подбора моделей и гиперпараметров.
Контекст
Больше всего времени в ML-проекте съедают проверка данных и повторяющиеся прогоны. Обучение модели на этом фоне – короткий этап.
Инструменты собирались так, чтобы неудачные направления отсеивались на ранних этапах, пока они стоят дёшево.
схема
Цикл работы с данными и моделями
из проекта
Инструменты команды
Что входило в задачи
Одна команда – полный отчёт по датасетуHTML-дашборд показывает, сколько данных собрано по каждому классу и где выборка перекошена, до того как начнётся обучение
Данные
- Дашборд по датасетуавтоматический разбор данных перед экспериментом
- Разбиение выборкиобучение, валидация и тест по повторяемым правилам
- Стратегии семплированияаугментация и балансировка перекошенных классов
Эксперименты
- Инфраструктура экспериментоводинаковые условия для моделей и методов обучения
- Свои компонентыфункции потерь, слои нормализации, архитектурные блоки
- Гиперпараметрыподбор и оптимизация в общем контуре
Результат
- Анализ метрикпоиск проблем в обучении до того, как они станут дорогими
- Отчётностьвыводы и рекомендации, с которыми можно идти к заказчику
Стек проекта
PythonPyTorchpandasJupyterтрекинг экспериментовDocker